
Softwares Supervisórios para Processos Distribuídos
Introdução
Softwares de Controle de Supervisão e Aquisição de Dados , também conhecidos como SCADA , são softwares projetados, a partir dos anos 80 , como a evolução dos antigos painéis sinópticos, amplamente utilizado nas décadas anteriores para monitoramento e controle de processos.
A evolução dos computadores trouxe uma tecnologia capaz de “encaixar” todas as informações em apenas uma tela, muito menor do que paredes e painéis utilizados antes. Assim enormes salas de controle encolheram para caber em um único PC. Além disso, em caso de alterações no modelo do processo, tornou-se fácil atualizar sua representação em software. Muito mais fácil do que quebrar uma parede ou redesenhar um painel!
Desde então SCADAs evoluíram apenas tecnologicamente, mantendo as mesmas características arquitetônicas.
A arquitetura tradicional
Os primeiros softwares de supervisão foram projetados para uma planta industrial, um processo local. Isso significa que o principal objetivo deste tipo de software é representar processos industriais em telas, armazenar dados de processo e tocar um alarme quando algo está errado, talvez alguns recursos extras.
E porque ele é projetado para processos tradicionalmente locais, estes softwares SCADA tradicionais não atuam tão bem em assuntos relacionados a plantas distribuídas, tais como restrições de comunicação, recuperação do histórico de campo ou atualização em massa.
Nos processos tradicionais da indústria todas as atividades são monitoradas por operadores fisicamente perto do processo. Isso significa que ambos processo e ser humano, estão localizados em uma única área física, uma planta industrial, por exemplo. Poucos metros separam a sala de controle do termômetro instalado em uma caldeira.
A Figura 1 ilustra um exemplo de processo e de controle de um modo muito tradicional, isto é, ambos no mesmo local. Uma usina hidrelétrica é um exemplo onde o processo é monitorado localmente.
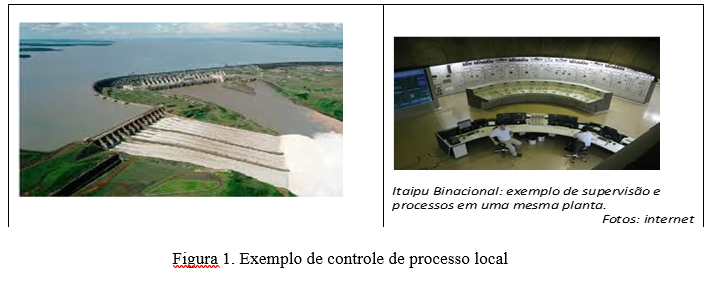
Softwares SCADA mais conhecidos em todo o mundo são projetados para a situação descrita . E isso é natural, uma vez que os principais processos na indústria são auto-monitorados, isto é, a equipe responsável pelo monitoramento de equipamentos e processos de controle , bem como a sala de controle ou Sala de Supervisão , estão localizados dentro dos limites da indústria.
Processos Locais x Distribuídos
Primeiro vamos definir “processo distribuído”.
Diferente do processo local, uma indústria de distribuição tem seus ativos instalados em muitos lugares diferentes. Então, imagine que a agência espacial americana, a Nasa, monitora todos os seus processos. Bem, a maioria deles são monitorados em Cabo Canaveral ou Huston. No entanto, embora muitos funcionários trabalham nestes locais, o lugar mais importante para a NASA, é claro, o espaço. São satélites, estações, telescópios e naves espaciais – processos distribuídos em locais muito distantes. Daí a importância da telemetria em processos distribuídos. Da mesma forma, linhas de alta tensão são o principal processo para uma empresa de transmissão elétrica, bem como tubos e dutos para concessionárias de água ou gás natural. Estas empresas não têm o seu equipamento ou processo localizados em um único lugar. Válvulas, tubos, medidores e todos os equipamentos, incluindo sensores, estão espalhados ao longo de milhares de quilômetros quadrados. Neste ponto, é muito importante fazer a distinção de processo distribuído e controle distribuído (DCS). Segundo a Wikipedia (2016), um sistema de controle distribuído (DCS) é um sistema de controle para um processo ou planta, em que os elementos de controle são distribuídos por todo o sistema. Ele pode ou não pode estar relacionado com um processo distribuído. Na verdade, os DCS foram concebidos principalmente para operações locais tradicionais. De qualquer forma, DCS é um tipo de controle e estamos considerando neste artigo um processo distribuído, como aquele encontrado em redes de transporte ou distribuição de gás. Neste artigo entendemos um processo distribuído aquele em que os elementos de monitoramento e controle estão a uma distância muito significativa, ou seja, 100, 200, 500 ou 2000 km! Ou mais! Uma concessionária de gás natural, por exemplo, tem as suas estações de transferência (City Gates) a quilômetros do ponto de venda. E ambos são também muito longe de sua sede, onde a sala de supervisão e controle normalmente está localizada. A partir desta característica fundamental da distância, vamos analisar alguns dos principais geradores de “gambiarras” na adaptação de software tradicional para atender aos processos distribuídos.
Gambiarra
No Brasil, gambiarra provem do Tupi-Guarani, Gambiarã. Significa acampamento provisório em território desconhecido; em território já conhecido é Ocabiarã. O significado predominante seria “improvisação”. Em computação, uma máquina , sistema ou programa que fora improvisado ou “ajuntado”; uma solução improvisada e mal pensada para uma falha ou ‘ bug ‘.
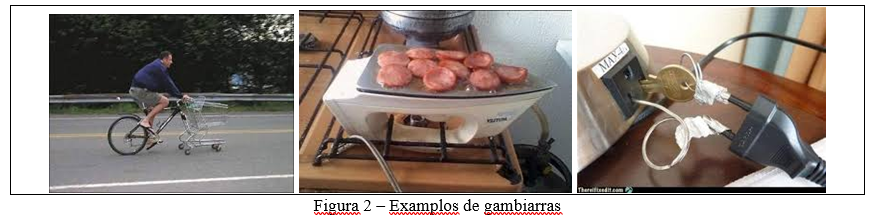
Como softwares tradicionais de supervisão foram projetados para indústria de processo local, eles não estão preparados para algumas situações de processos distribuídos.
Mas como eles são bem conhecidos pelo mercado, muitos profissionais optam por usar um software tradicional, ainda que tal software exija alguma “adaptação”. O problema aparece quando tais adaptações se transformam em ‘gambiarras’. O principal problema das gambiarras é que elas realmente funcionam! Não tão bem, não por muito tempo, mas elas funcionam! Muitas gambiarras estão funcionando neste exato momento em muitos processos distribuídos críticos, como gasodutos.
Exemplos de gambiarras em implantações de SCADA
Ao implementar sistemas SCADA usando o software tradicional sobre processos distribuídos (como distribuição de gás), encontramos algumas ” adaptações técnicas ” relativas às seguintes questões:
- O cadastro de usuário
Em um SCADA tradicional, o registro de usuário é limitado apenas ao nome, login e , às vezes , departamento. Qualquer outra informação exigida por outro sistema requer uma nova inscrição. Ex: para usar e- mail para enviar mensagem de alarme, naturalmente será necessário registar o e-mail do usuário. Como não há nenhum banco de dados relacional para armazenar as informações, há que se cadastrar novamente o usuário em um outro programa. Não há nenhum registro central.
Então, para ter todas as funcionalidades, para cada novo usuário, devem-se atualizar muitos sistemas e bases de dados diferentes - Disponibilidade de Comunicação
A menor disponibilidade de um canal de comunicação entre o SCADA e o campo muda completamente a forma de comunicação em sistemas distribuídos.
Por exemplo, em uma planta tradicional falhas de comunicação são raras. Mesmo quando elas ocorrem, a detecção e a correção são praticamente imediatas, uma vez que os elementos de rede são acompanhados de perto.
Nas redes de comunicação a distância, como rádio, GPRS e satélite, pequenas interrupções na comunicação são naturalmente aceitas. A falha das operadoras de telecomunicações podem causar interrupções de dias. Consequentemente, para a medição do consumo, é obrigatório o registo de dados armazenados em campo, independentemente da disponibilidade de comunicação. Consequentemente o SCADA deve ter a capacidade de recuperar o histórico de campo. Algo desnecessário em uma planta industrial. A supervisão tradicional é projetada para leituras instantâneas, e não para a recuperação de logs.
A solução tradicional aqui é instalar um terceiro software, que se comunica com o SCADA, mas não totalmente integrado, reduzindo funcionalidades. Demanda-se a criação de mais scripts para atender às necessidades. Mais scripts, menos performance. - Arquitetura de Comunicação
Hoje a maioria dos canais de comunicação usam TCP / IP como veículo para transportar dados. Todos os operadores de celulares usam o GPRS, 3G (UMTS) ou 4G (LTE) e são baseados em protocolo TCP / IP. Isso deveria ser suficiente para padronizar todas as conversas entre SCADA e equipamentos de campo. Mas isso não acontece.
Na comunicação TCP temos dois lados importantes: aquele que inicia a comunicação (lado do cliente) e o outro que “espera” para uma ligação (lado do servidor). Ao SCADA é suposto requerer alguns dados; naturalmente, ele é projetado para agir como um cliente. Então, no outro extremo temos o modem campo, que é suposto agir como um servidor, a fim de “esperar por uma conexão” do SCADA. No entanto, as redes de telefonia celular são projetadas de forma que cada dispositivo – não importa se é um modem de telemetria, um smartphone ou notebook – é considerado um terminal, ou seja, um dispositivo para iniciar a conexão (cliente) e não um dispositivo para receber uma ligação (SERVER ).
Então, teremos ambos os lados (modem de campo e SCADA) querendo iniciar uma conexão, mas é preciso que um opere em modo listening … E agora?
A “solução” aqui, varia de software adaptado (que funciona como SERVER-SERVER) a até alguma solução bizarra usando “SimCards de IP fixo”. Como redes celulares não são projetadas para servidores, elas não fornecem IP fixo para dispositivos. Quem oferece “IP fixo”, na verdade, usa alguns artefatos (tais como VPN) para prover um IP fixo “virtual”. Quanto mais “artefatos” menos confiável é seu sistema. - Tags
De acordo com a GE (2011) , Tags são ” unidades individuais de instruções armazenadas no banco de dados que são capazes de receber , verificar, manipular prover a saída de valores de processo . As tags também pode comparar um valor de processo contra um limite de alarme (set-point) e realizar cálculos com base em um valor de processo específico”. Basicamente, uma tag é uma variável do processo.
Agora, imagine quantas variáveis diferentes uma indústria tem de acompanhar. Centenas, talvez milhares. Naturalmente, cada tag (etiqueta) tem de ser inserida , uma por uma . Isso é ok , quando você tem milhares de diferentes tags como no exemplo da figura.
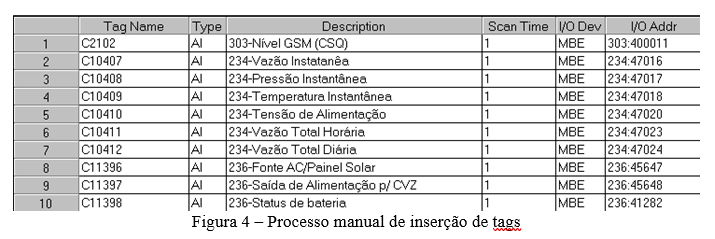
Mas imagine esta situação: uma distribuidora de gás tem 1.544 clientes que utilizam o mesmo tipo de estação de medição. Cada um deles monitora cerca de 50 variáveis. Então há 50 x 1544 = 77.200 tags a serem inseridas no sistema. Se levarmos 30 segundos para inserir cada tag , levaríamos 624 horas contínuas para uma pessoa ‘doente’ definir todas as tags!
No entanto, todos os clientes têm o mesmo “mapa de Tag”, isto é, todos os clientes têm a mesma configuração de 50 tags . Não seria muito mais fácil se nós apenas definíssemos um modelo de 50 -tags e podéssemos copiar ou “carimbar” este modelo para cada cliente ?
Um software tradicional não está preparado para isso. Uma solução “alternativa” (gambis?) é copiar manualmente cada tag e substitua cada valor específico para a nova estação. E que deve ser repetido para o driver e para a aplicação.
- Scripts
Scripts são instruções programáveis, pré compiladas, para permitir que os integradores possa implementar diferentes funcionalidades ao longo do SCADA . Eles são muito úteis quando queremos algo diferente do que o software oferece, mas deve ser usado com cuidado. Muitos scripts são tão longos e complexos que até mesmo o autor não sabe bem como funciona. E uma vez que a estrutura de scripts é bastante diferente do programa original, provavelmente haverá perda de desempenho.
A maioria destas ‘adaptações’ ocorrem porque o software tradicional não usa banco de dados relacional . Hoje em dia banco de dados relacional é quase obrigatório para organizar dados em sistemas complexos.
O novo paradigma
A nova geração de softwares deve seguir os novos hábitos das pessoas. Hoje, uma criança de quatro anos de idade pode tomar o nosso smartphone, chamar a avó e jogar o seu jogo favorito. Este padrão “easy- to-use” deve ser o foco principal para novos desenvolvimentos de software. Um operador deve usar um SCADA tão facilmente como as meninas na figura 4 operaram o tablet.
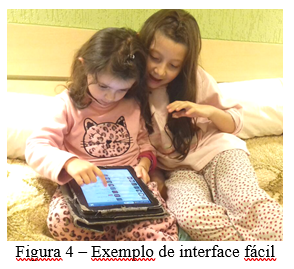
Não só fácil , a interface deve ser padronizada, de modo que o que você vê em “vídeo wall” deve ser o mesmo que você vê em tablets, desktops ou smartphones , independentemente da resolução. Felizmente, novas tecnologias adaptam resolução a qualquer dispositivo de acordo com o tamanho da tela.
Além disso, softwares estão tão avançados que muitas funcionalidades já estão disponíveis, a maioria livre. Então, é hora de se preparar para uma nova geração de sistema SCADA. Uma geração de software que é :
- “pronto para uso” : não há necessidade de construir telas, tags de link e variáveis , definir centenas de configurações;
- Já instalado : a maior parte do custo para implementar SCADA é a infra-estrutura. A nova geração é baseada em nuvem , não importa se dentro da empresa ou em um datacenter externo ( ou mesmo ambos !). De qualquer forma , o custo deve ser básico, bem como a complexidade. Soluções simples funcionam melhor.
- Universal : a mesma tela deve ser vista na TV , Smartphone , vídeo-walls, desktops, não importa seu tamanho ou resolução de tela.
- Integráveis : dados devem fluir através de diferentes bases de dados e sistemas, através de Webservices, preferencialmente.
- Escaláveis : a partir de apenas um dispositivo até milhares de pontos. E quando usar um, pagar por um, não milhares.
- Adaptativos: as mudanças , os sistemas devem ser fáceis de ajustar
Conclusão
Louis L’ Amour disse: “A única coisa que nunca muda é que tudo muda”. Mas não é verdade. Mesmo alterações mudam. A velocidade das mudanças e a maneira como lidamos com elas são a força impulsionadora da nossa evolução.
Referências
WIKIPEDIA . Distributed control system. Available at https://en.wikipedia.org/wiki/Distributed_control_system, May,30 2016.
GE, Ifix Electronic Books, 2011, GE Intelligent Platforms, Inc.